
要点方案要点
我们对multilingual-e5-base开展了应用研究——研究了该语言模型对语体风格的敏感性,并提出一种微调方法,以减少跨语言任务中的错误。研究成果是一个Gabriel Graph,用于展示哪些作者写出了彼此相似的文本:如果模型认为两段文本“相互敏感”,相应作者之间就会建立连接。该研究已应用于客户的多个语言模型,并作为衡量数据关联“温度”的指标。
工程实施过程03
- 0101
问题研究
分析现有的文本风格提取方法与度量学习(metric learning)架构。
- 0202
数据集准备
构建文本样本,并标注作者特征与风格特征。
- 0303
神经网络架构开发
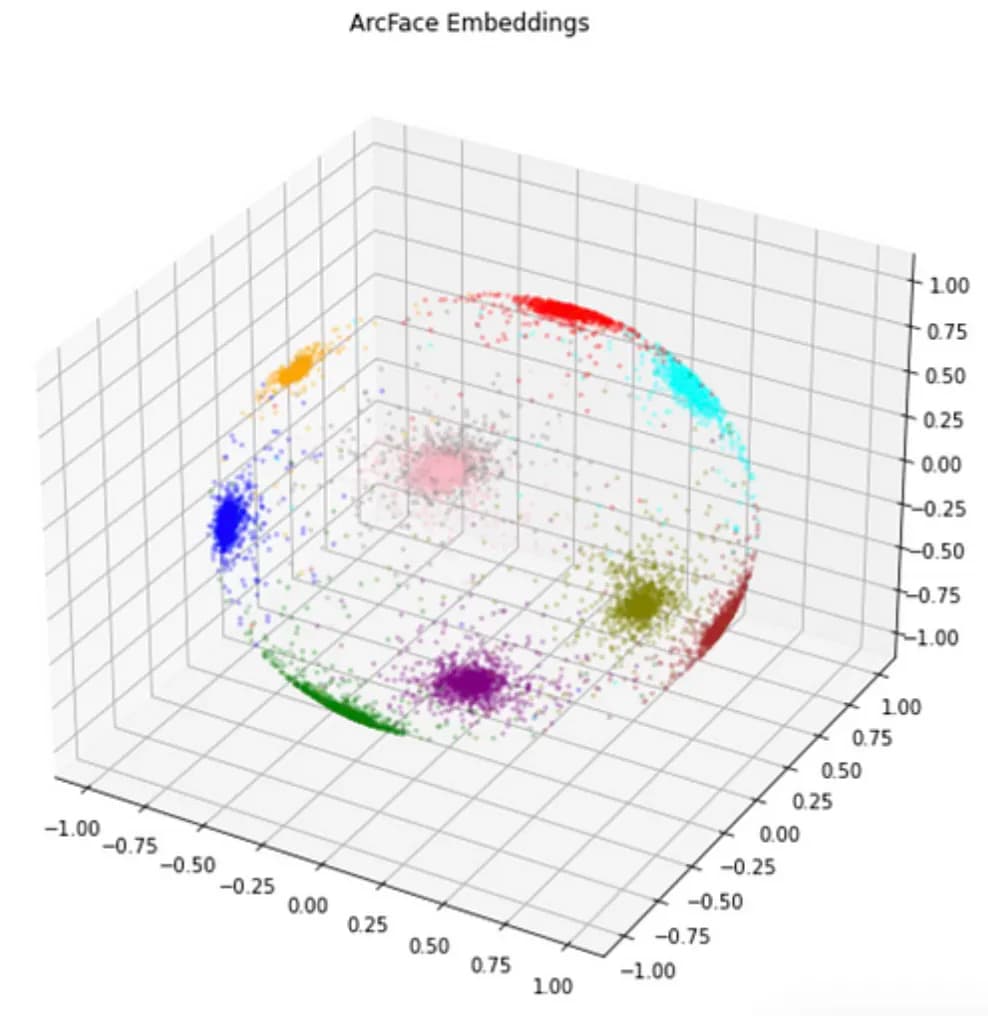
基于ArcFace、SphereFace和CosFace损失函数构建模型。
- 0404
对比学习
通过对比学习方法训练系统提取文本风格特征。
- 0505
质量评估
验证基于短文本片段的作者识别准确率。
- 0606
研究成果整理
整理研究成果,并拓展AI生成文本检测方向。
成果成果04
+8个百分点Precision@10
−23%跨语言错误
6研究覆盖的语言
記録项目图集05
技術技术栈
- 01PyTorch
- 02HuggingFace
- 03multilingual-e5-base
- 04Python
- 05Streamlit
- 06CUDA
- 07TensorBoard
- 08LangChain
有类似需求?
我们将在5个工作日内完成沟通与评估。